鹈鹕测试:同一句提示词,66 个模型各自画出了什么
一句 8 个词的提示词——「Generate an SVG of a pelican riding a bicycle」——被喂给两年来几乎每一个新模型:从 2024 年 10 月的 16 个,到现在的 66 个模型、103 张图。它从来不是严肃基准,作者本人还专门写过"别拿它比较模型"。但它把"模型到底会不会画"这件事变成了一眼能看懂的东西——这篇文章就按时间线,把各家画出来的东西摆给你看。
以下作品均来自公开来源(Simon Willison 的 pelican benchmark 及其镜像站 pelicanzoo.ai),逐张标注出处,版权归原作者。
先说结论
它不是基准,但它是这一轮模型能力最好看的横截面:2024 年那批是"两个圆加一个三角形",2026 年这批已经是能直接放进插画里的成品。
而它的口味很刁:这个任务的成败跟审美无关——模型看不见自己画的东西,也没法中途修改,只能一次把一堆坐标和路径拼成"鸟骑车"。测的其实是"一次性生成复杂结构"的能力。
一、为什么一句 8 个词的提示词能出圈
作者选这个题目,理由很朴素:他喜欢鹈鹕(住在海边),并且确信训练集里不可能存在"骑自行车的鹈鹕"的 SVG。
更关键的是这三点:
- 没有反馈闭环——语言模型看不见自己画了什么,只能用坐标和半径盲拼,中途没有机会"看一眼再改";
- 自行车很难凭记忆画——不信你现在试着画一辆,车架几何大概率是错的;
- 鹈鹕形状天生不适合骑车——作者原话:"Pelicans can't ride bicycles. They don't have the right shape."
白送一个彩蛋:模型会在 SVG 里写注释,<!-- wheels -->、<!-- frame -->、<!-- pelican legs -->……于是可以对比"它打算画什么"和"它画出来什么"——差距通常就是笑点。
二、两年时间线:图 + 数字
2024-10 · 首测 16 个模型
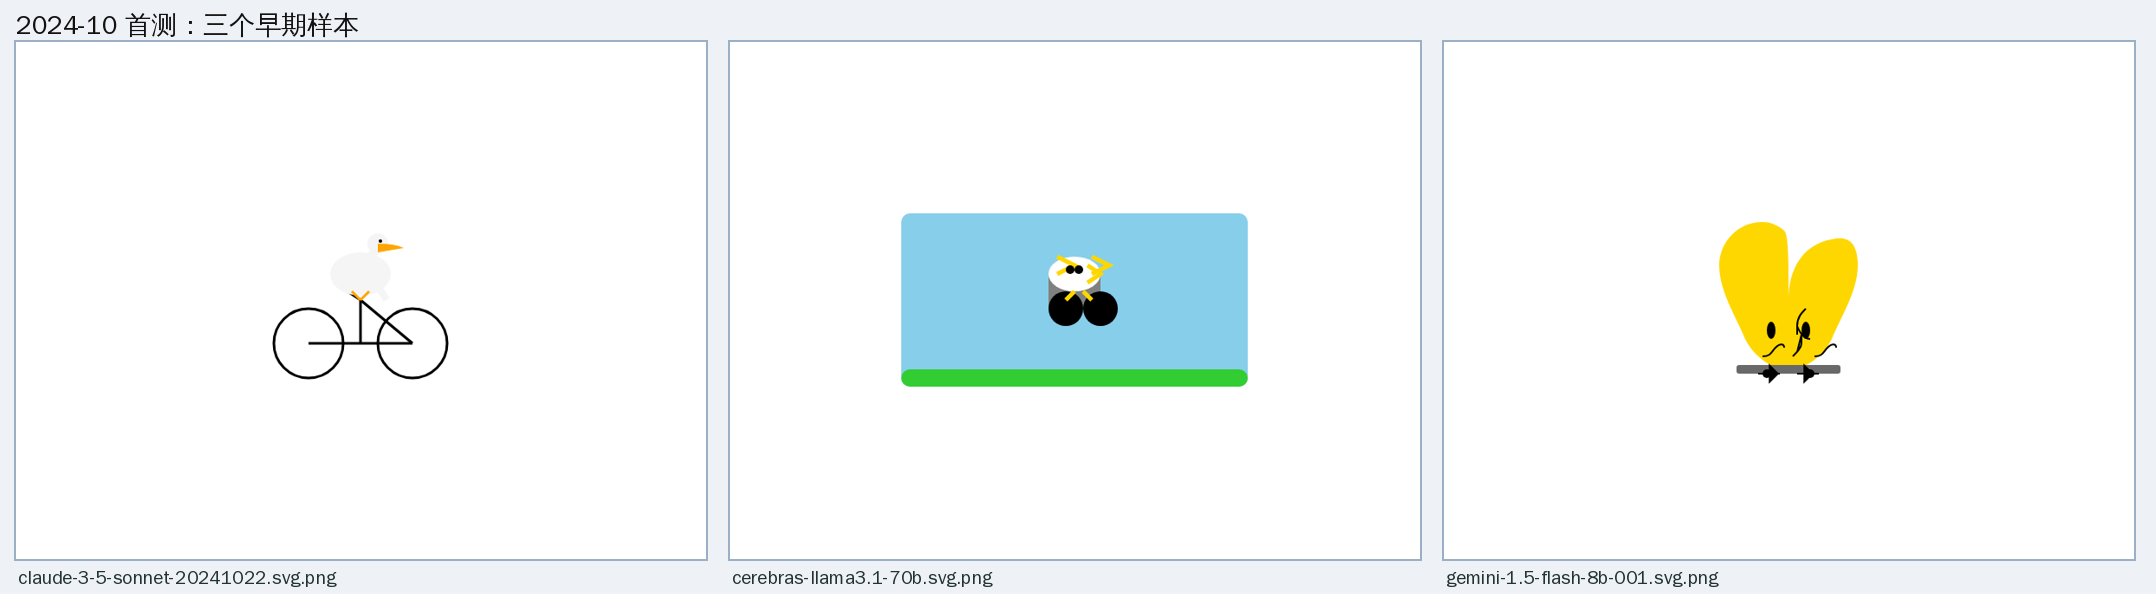
左:Claude 3.5 Sonnet(2024-10-22)——两个带辐条的车轮、简单车架,上面一只小鸟,居然还算像样;中:Llama(Cerebras 版)——蓝色底、绿色地面,中间一团黑白形状,看不出鸟也看不出车;右:Gemini 1.5 Flash 8B——两团黄色,作者给了"特别提名"。
同批被记住的评语还有:更早的 Claude 3.5 Sonnet(2024-06)画的是"两个圆加一个三角形,喙像黄色香蕉笑脸";Qwen2.5-Coder 像拖拉机;Mistral Small 3 是"蹲在杠铃上的鸭子"。
2025-06 · 34 张图,两两对战排出 Elo
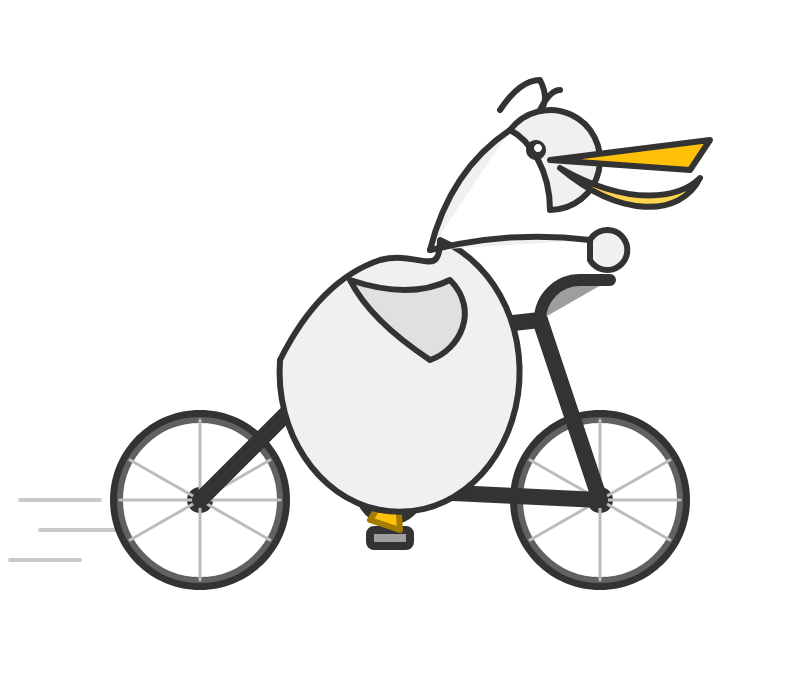
图攒到 34 张后作者不想自己看了,于是让 Claude 写了个两两对战工具:560 场比对,评判总成本约 18 美分,得出 Elo 排名。冠军是 Gemini 2.5 Pro 预览版,末位是 Llama 3.3 70B。
2026-02 · 第一次出现"能用的插画"
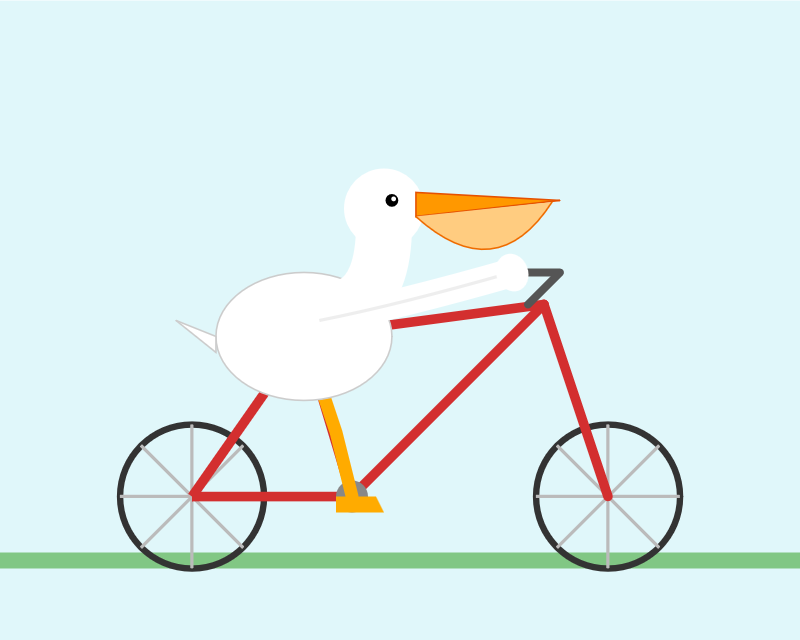
这张被形容为可以直接用的插画——干净线条、车架正确、鸟有喙袋和眼睛。从"两个圆"走到这里,花了一年零四个月。
2026-04-16 · 笔记本上的小模型,赢了一线大模型
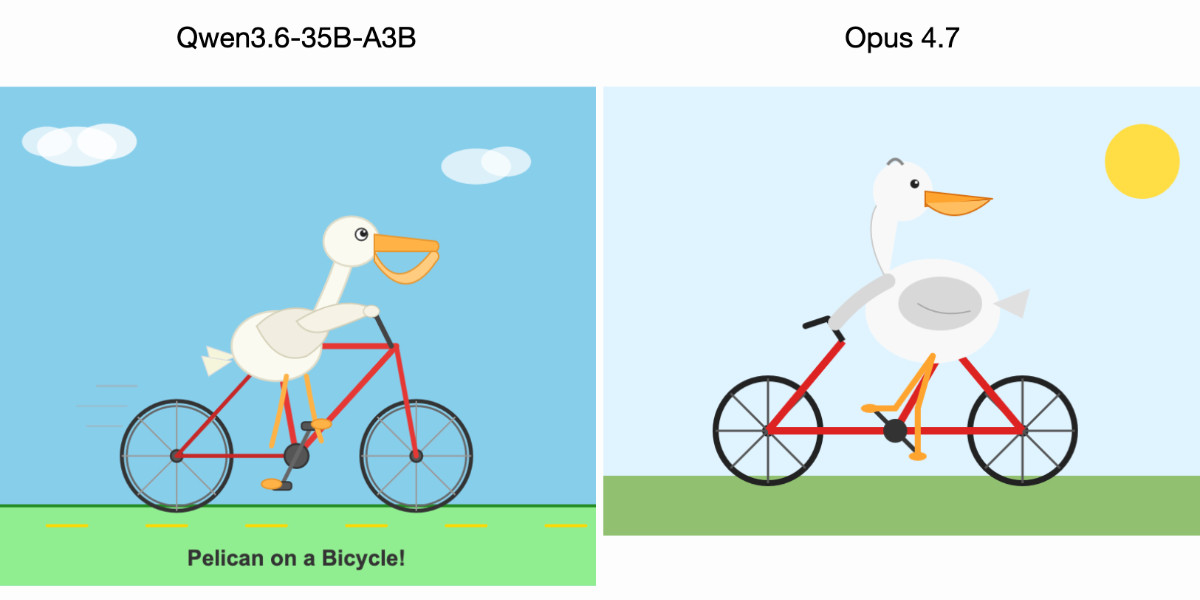
同一天发布的两个:左边 Qwen3.6-35B-A3B(20.9GB 量化、跑在笔记本上)画得清楚又完整;右边 Claude Opus 4.7 的车架几何是错的——把思考档拉满再画一次,还是错。
2026-05 · 21 个量化版本横扫:全崩,且与体积无关
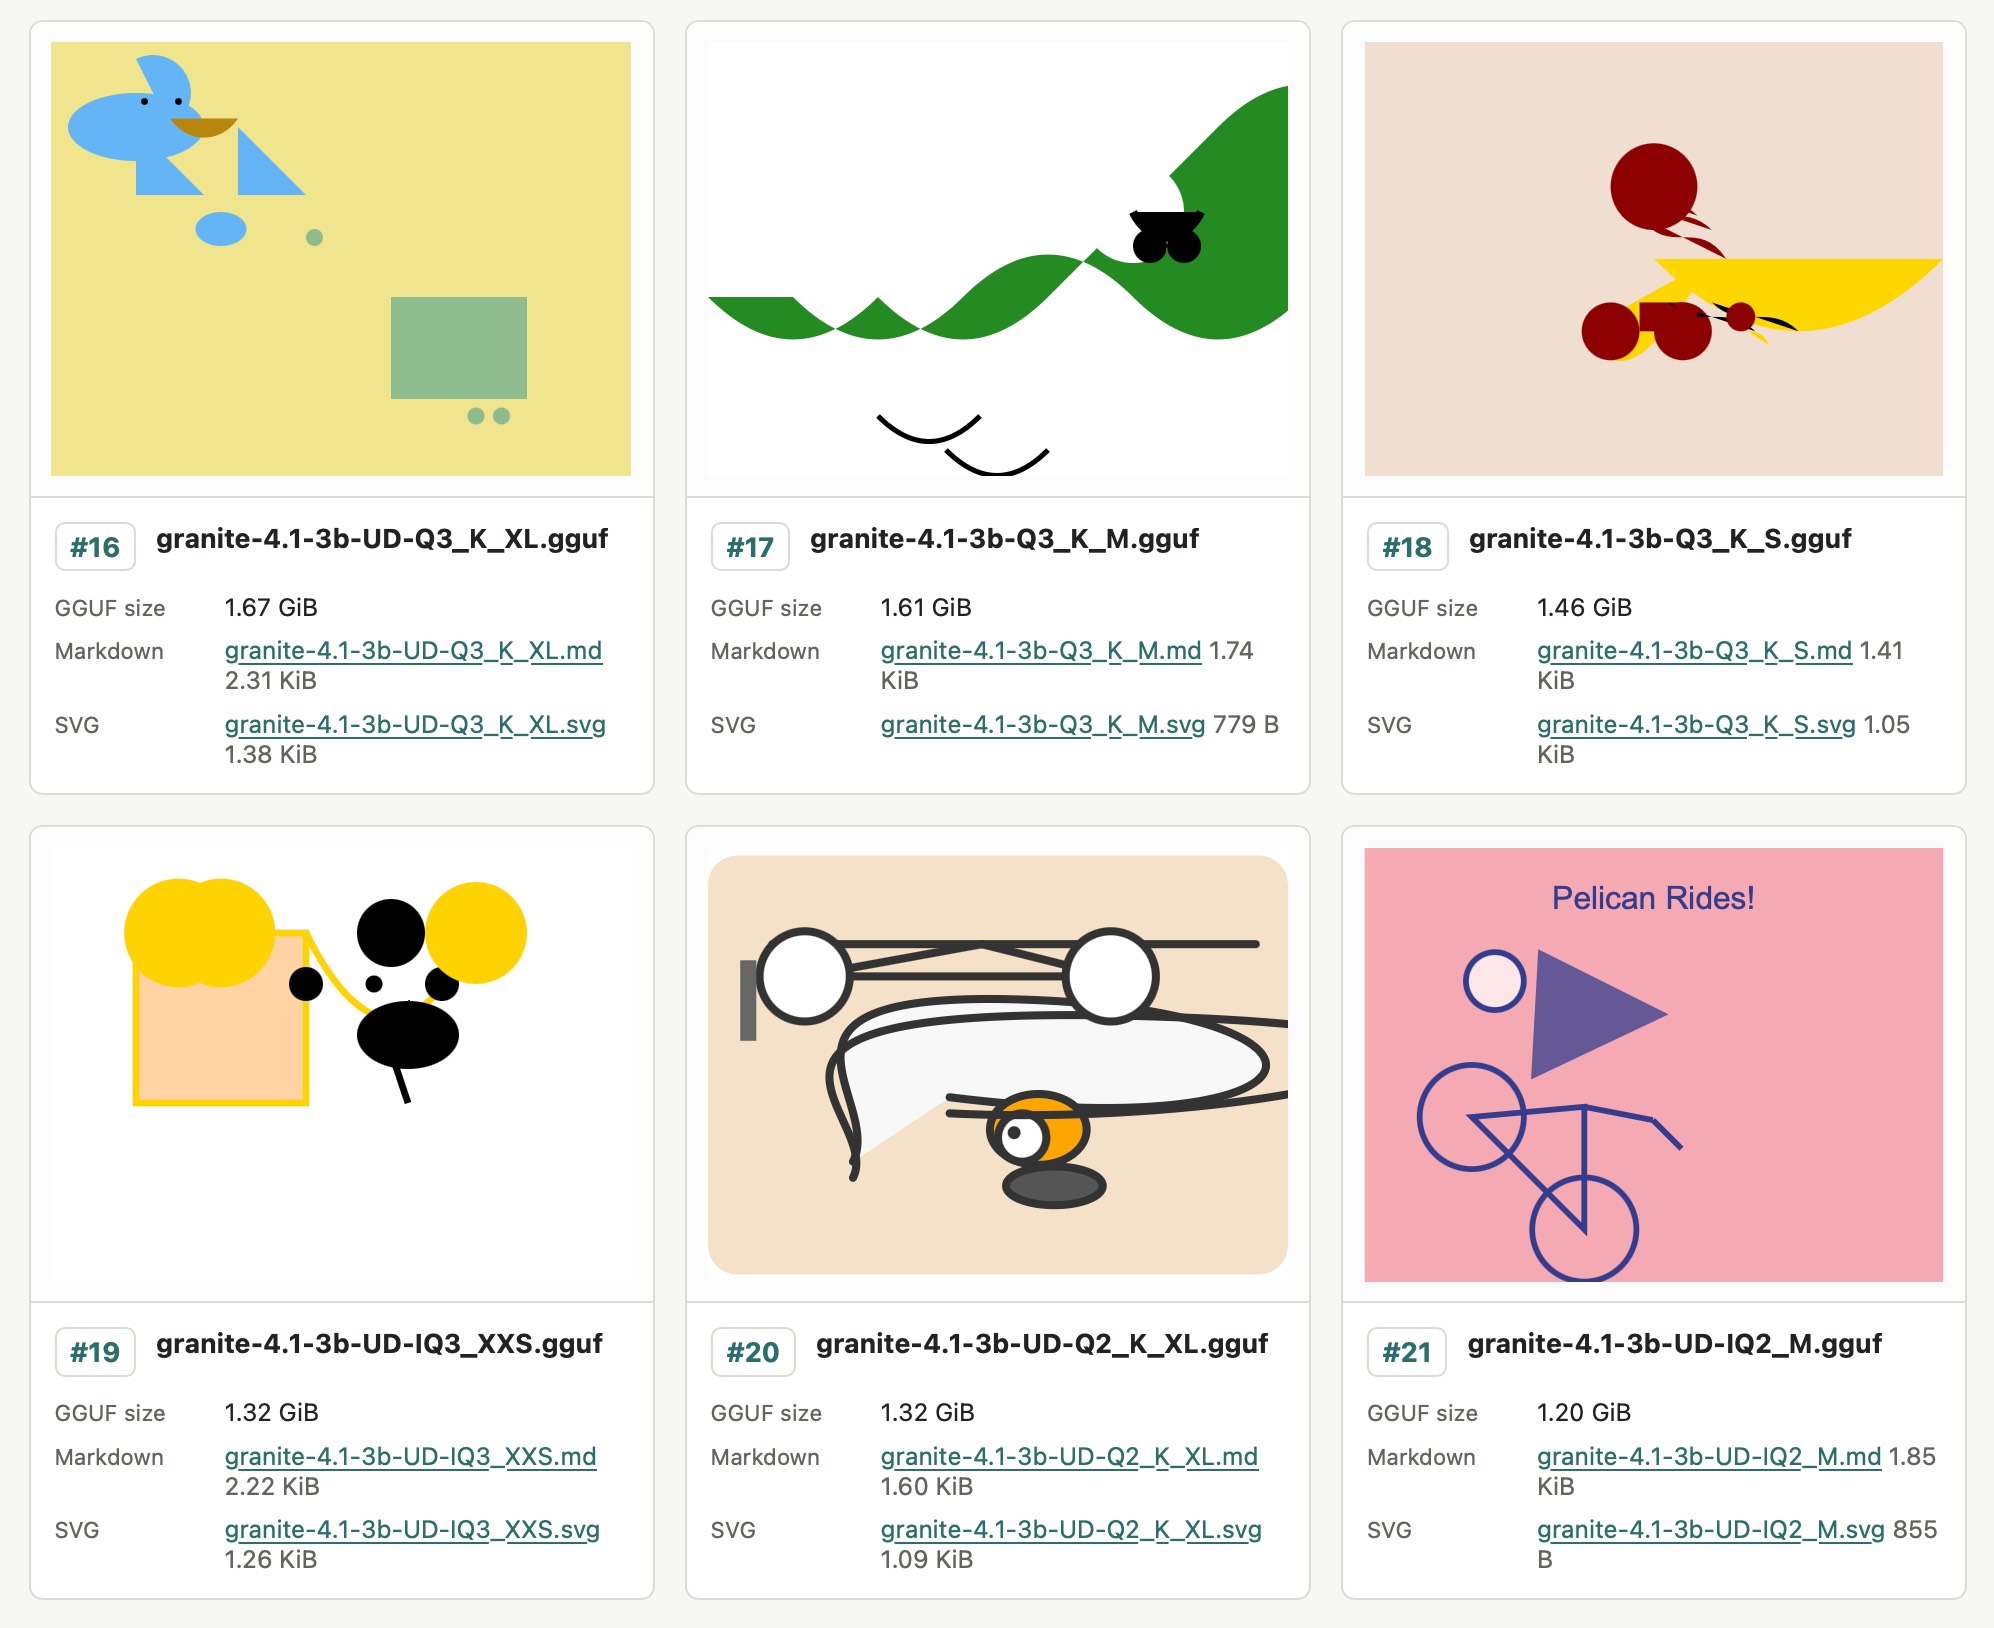
这张网格是 Granite 4.1 3B 的 21 个量化档(每格标了 GGUF 体积)。结论有两条:整体全崩,而且和体积没有相关性——1.2GB 和 6.34GB 一样画不好,反倒是很小的那个(IQ2_M)交出了一辆能认的自行车,还给配了文字 "Pelican Rides!"。
2026-09 · 同一张网格上,单张成本差 40 倍
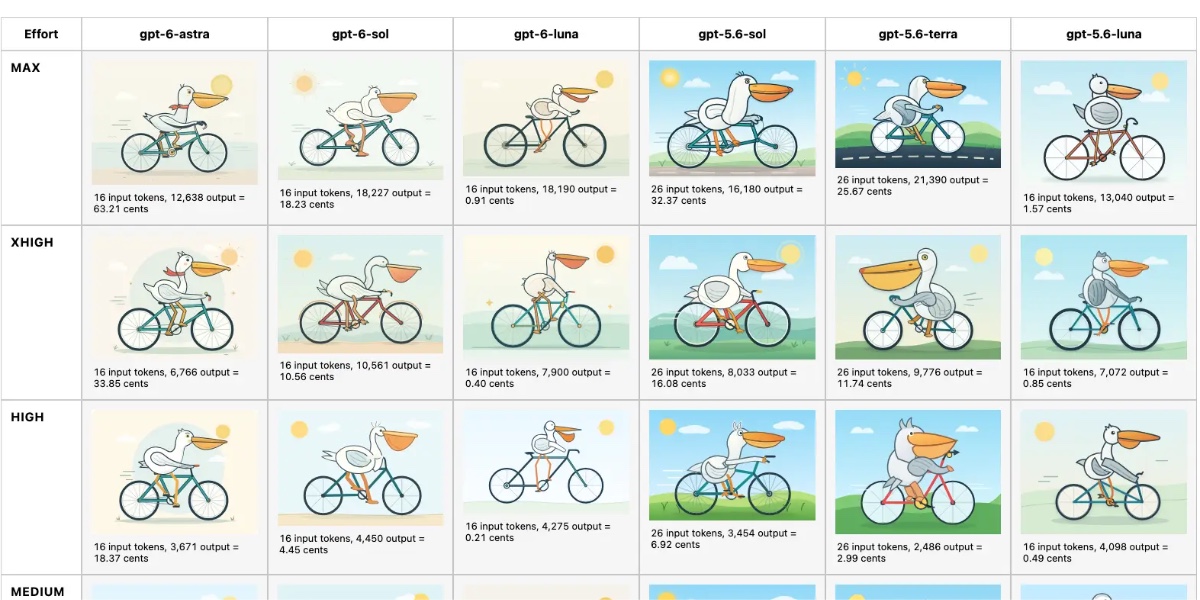
这张网格的每一格都标了输出 token 和成本:单张鹈鹕从 1.57 美分到 63.21 美分。同系列里,GPT-6 Astra 的低档就已经胜过 GPT-5.6 Sol 的全部作品(9.55 美分)。也就是说,你在榜上看到的"差距",有时只是别人把档位开满了。
2026-09-01 · 最大思考档:13 分 54 秒、$3.30
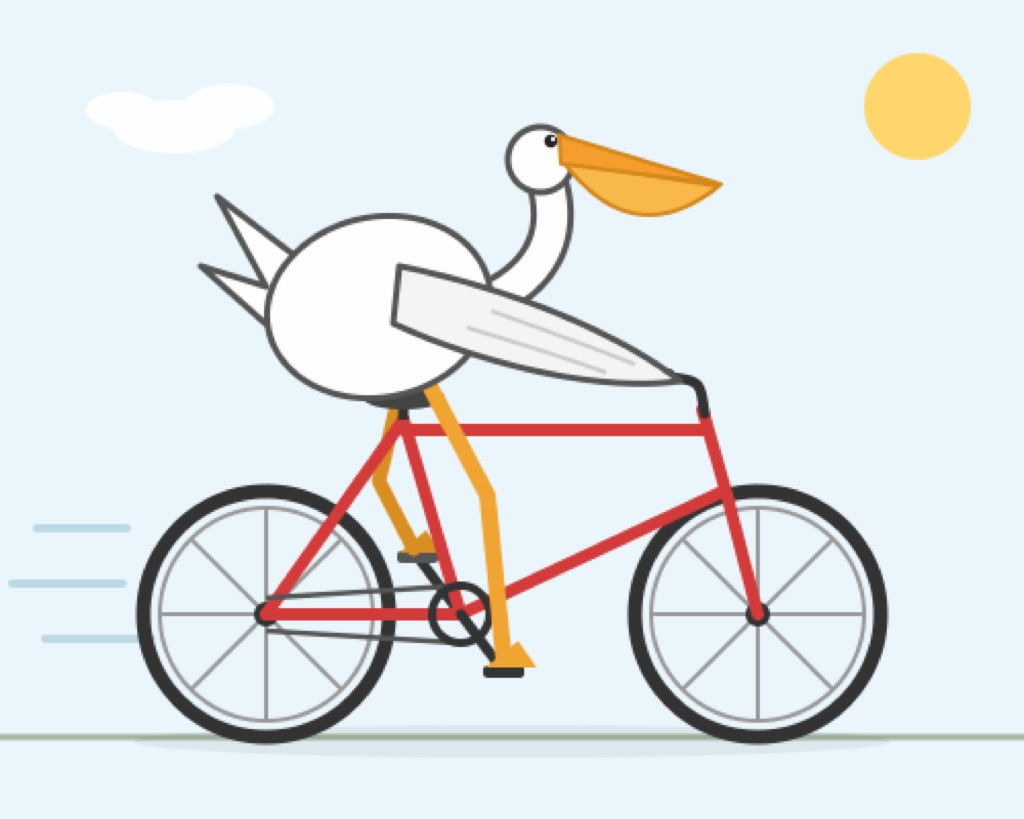
同一个模型分 5 档思考,最大档跑出了 13 分 54 秒、65,927 token、$3.30。它还自己给鹈鹕加了顶蓝帽子、在车篮里放了一条鱼——这时候已经不是"画得像不像",而是"它想不想加戏"。
三、2026 年,各家的"鸟骑车"都长什么样
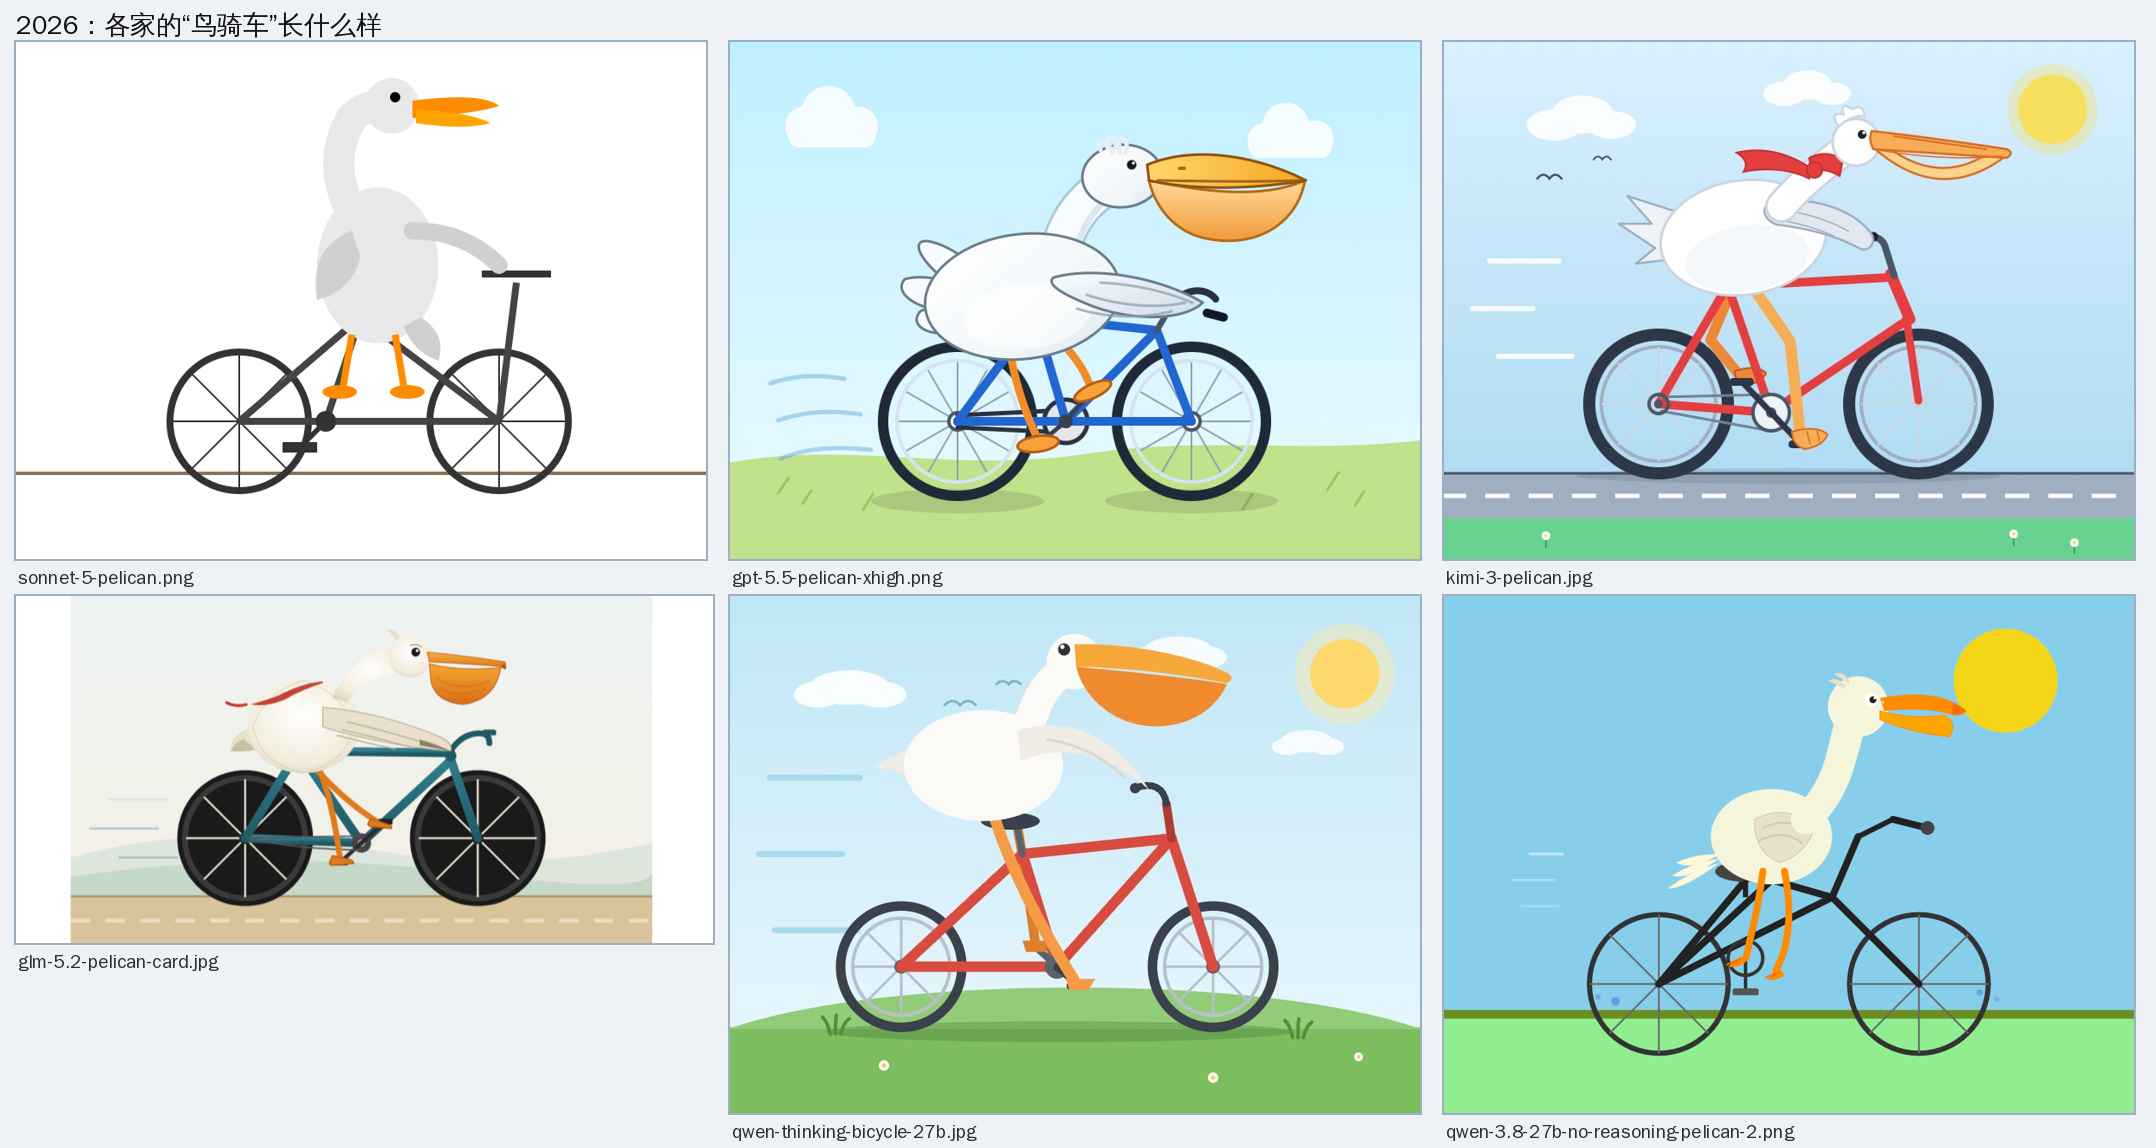
从左到右、从上到下:
- Claude Sonnet 5:白底线条画,鸟身是个灰块、橙色喙,自行车是细致线稿。像鹈鹕,但更像一只鹅——喙袋没了。
- GPT-5.5(xhigh):最"标准"的一张,喙袋、橙腿、蓝车架、草地和云俱全,还画了溜车的速度线。
- Kimi K3:最有设计感——红围巾、红车架、灰色带虚线马路的公路,太阳和云都在。开始有人给它"造型"了。
- GLM-5.2:柔和配色、黑色车轮、米色背景,整体像个安静的矢量插画;鸟头的位置略微别扭。
- Qwen3.8-27B(思考档):大喙袋、红车架、绿草地,干净利落。
- Qwen3.8-27B(关掉思考):同一模型的另一个版本——车架变黑、太阳变大、鸟更像鹳。风格相近,细节不同。
一句话总结这一排:到 2026 年,"能不能画出来"已经不是问题了,问题变成"画得像谁"。
四、也有一直画不好的
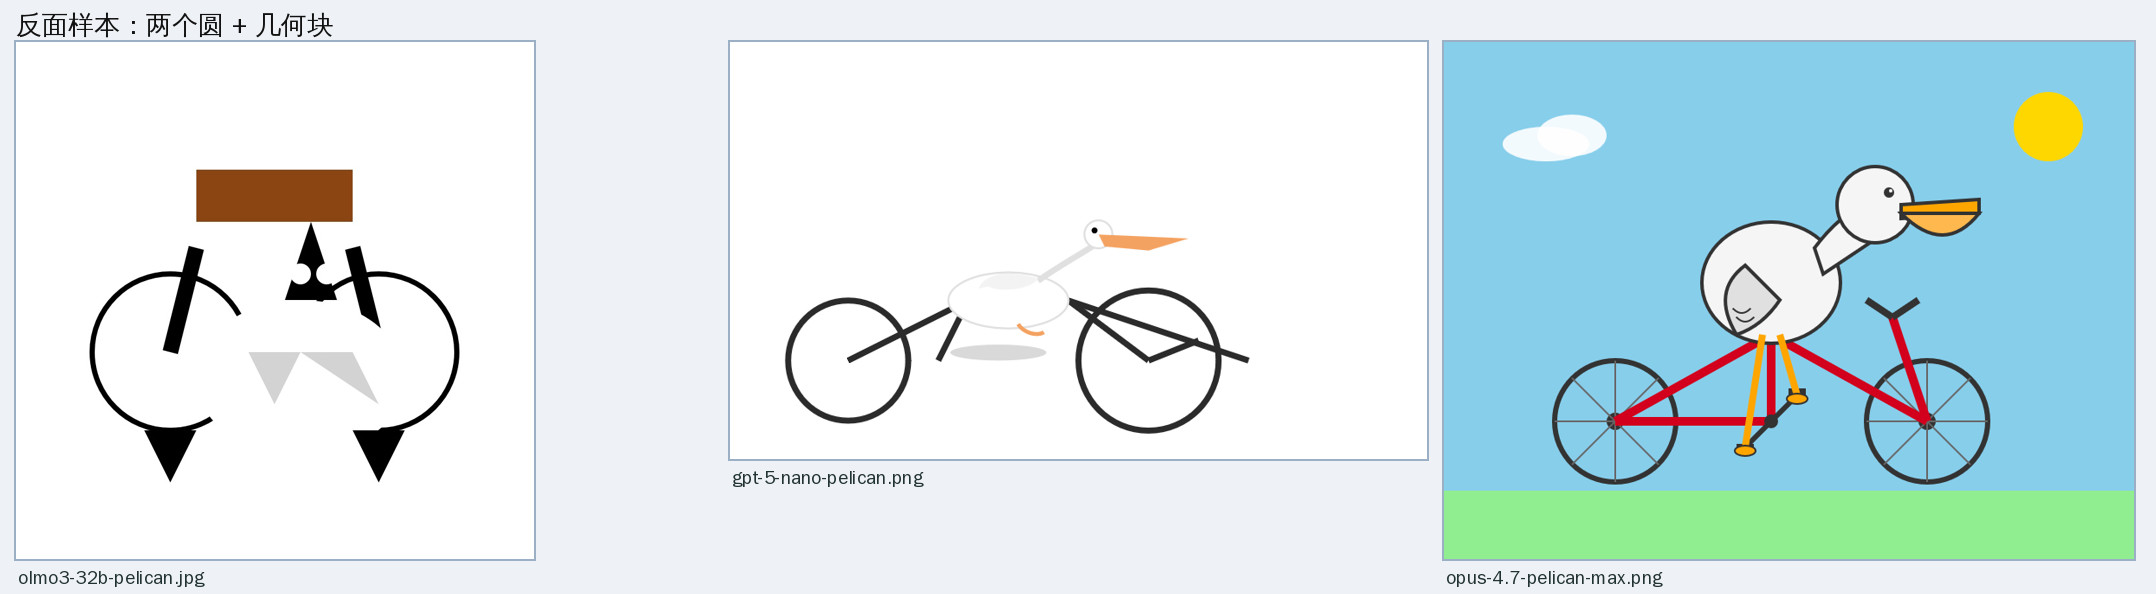
左:OLMo 3 32B——真的是"两个圆 + 几个几何块"(一块棕色矩形、两片灰色三角),看不出鸟,也看不出车;中:GPT-5 nano——自行车骨架勉强认得出,鸟是一团白影;右:Claude Opus 4.7 最大档——看着像样,但作者的评价是"车架形状完全是错的,只是错法不同"。
这三张摆在一起说明一件事:同一个测试能把不同量级的失败方式分开——有的是不会画(OLMo),有的是会画但懒得画完(GPT-5 nano),有的是画得很像样但结构错了(Opus 4.7 max)。
五、三条反直觉的结论
1. 作者自己说"别拿它当基准"。 第一年确实存在"鹈鹕画得好 ≈ 模型好用"的相关性,现在基本没了——GLM-5.2 的鹈鹕画得比一线模型还好,但他不认为 GLM 属于那个级别。更重要的是,它测不了今天真正重要的东西:长对话保持与工具调用可靠性。
2. 推理档位的影响,常大于模型之间的差异。 同一张网格上,成本差 40 倍、耗时从 7 秒到 13 分 54 秒。
3. 量化不是主因,"底座本来就不会画"才是。 Granite 那个案例里,底座就在能力地板附近,任何量化方案都测不出差别——先确认底座够强,再做量化对比,否则测的是噪声。
六、本机 125B 也跑了两条赛道
拿本地部署的 Qwen3.8-Flash-Next(125B 稀疏 MoE,IQ3_S 量化档)跑了同一道题。
经典赛道——同一提示词连问三次:
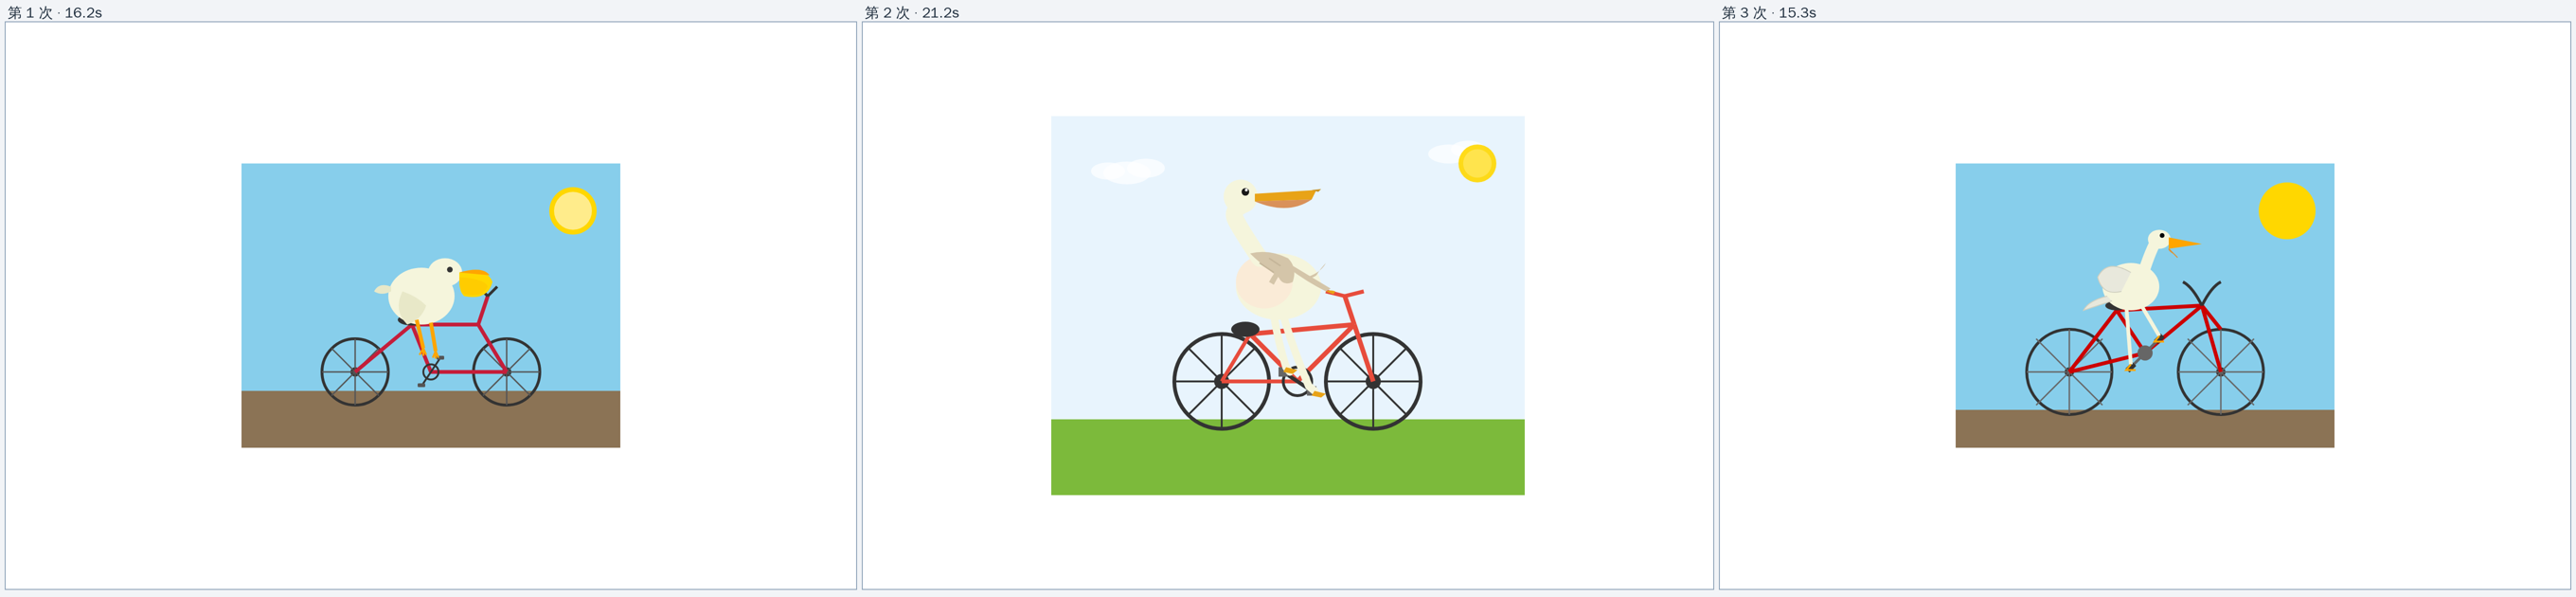
16.2 秒、21.2 秒、15.3 秒,三只完成度肉眼可见地不同:车架几何三次都对,差别出在鹈鹕本体(喙袋、脖子长度、翅膀)。也就是说,它"懂自行车怎么构造",但对"鹈鹕长什么样"只有模糊印象。
动画赛道(社区对比里那句更狠的提示词:车轮转动 + 蹬踏动作):
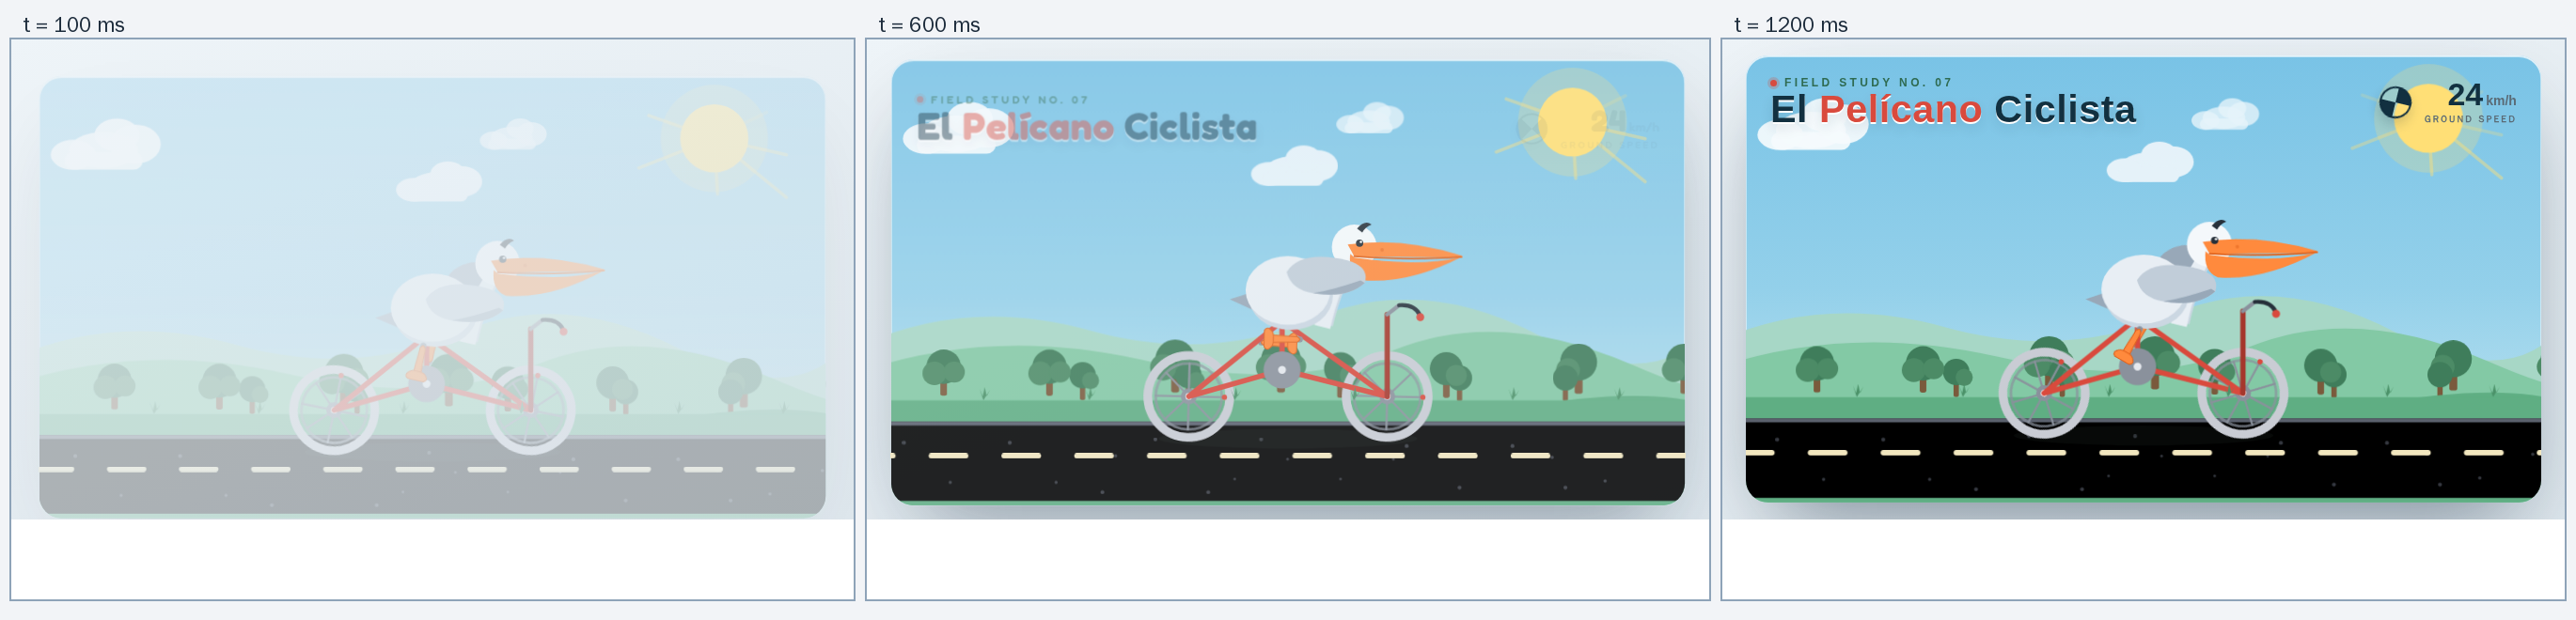
97.5 秒生成了一个 28,204 字符的完整 HTML:HTML 里定义了 7 组 @keyframes(spin、roadMove、groundMove、drift……),两个车轮各挂一个 wheel-spin 元素配 360° 旋转,路面在移动、云在漂移。它给了这个场景一个标题"El Pelícano Ciclista",右上角还有块速度表显示 24 km/h。
本地这份成绩放在榜单里算中上:能出成品、能出动画,但别指望它每次都稳——同一提示词三次采样就有明显方差。(调参细节另见本站另一篇。)
七、这个测试测什么、不测什么
测:在一个"看不见自己作品、无法迭代"的封闭条件下,模型能不能把一大堆坐标和路径组织成结构正确的成品。这更接近"一次性生成大段结构化代码"的能力,而不是审美。
不测:长对话保持、工具调用可靠性、指令遵循的边界——也就是今天真正决定"能不能干活"的那几项。
但它有个别人替代不了的作用:它是唯一一个"结论一眼可验证、还能存成文件"的测试。一张 SVG 就是一份可复现的证据——包含坐标、注释、结构,能量化(token、耗时、成本),也能一眼看出崩在哪。看排行榜你要信它的分数,看鹈鹕你自己就会判断。
参考
- Simon Willison 的鹈鹕合集(原始出处,含每次发布的点评与全部 SVG):https://simonwillison.net/tags/pelican-riding-a-bicycle/|官方图库仓库:https://github.com/simonw/pelican-bicycle
- 103 张作品的镜像整理(本文多张图出自此处):https://pelicanzoo.ai/
- 社区投稿(经典 SVG / 动画 HTML 两条赛道):https://pelicanbenchmark.com/
- 105 个模型的动画 SVG 横向对比:https://rmohid.github.io/svg-model-compare/
- 同题横向对比的中文整理:36氪《一只鹈鹕成了 Agent 时代最大的明星》
- 图片来源:正文中的模型作品均截取自 Simon Willison 的 pelican benchmark 及其镜像站,版权归原作者,本文引用并逐张标注;本地两图(经典三次、动画三帧)为本文实测输出
- 数据口径:本地侧耗时/token 于 2026-10-15 在自有服务器(RTX 5090 / 62 GB 内存)上采集,单次采样未取均值;榜单侧数字引自上列来源,各自时点不同