15 秒出图,155 秒交白卷:本地大模型的三个坑
同一句提示词、同一个模型,一次 15 秒出图、一次 155 秒零输出——差别不在模型能力,而在三个设置:思考档会先把输出预算吃光、输出上限决定成品会不会被截断、以及 agent 训练痕迹会让它“去调工具”而不是直接给成品。文中的耗时与 token 全部来自本地 125B 稀疏 MoE 的实测,末尾附四条可直接用的规矩与口径。
共 4 篇文章 · 全部标签
同一句提示词、同一个模型,一次 15 秒出图、一次 155 秒零输出——差别不在模型能力,而在三个设置:思考档会先把输出预算吃光、输出上限决定成品会不会被截断、以及 agent 训练痕迹会让它“去调工具”而不是直接给成品。文中的耗时与 token 全部来自本地 125B 稀疏 MoE 的实测,末尾附四条可直接用的规矩与口径。
一句 8 个词的提示词「Generate an SVG of a pelican riding a bicycle」,两年里 66 个模型、103 张图。这篇按时间线把各家作品摆出来:2024 年的“两个圆加三角形”、2025 年的 Elo 对战、2026 年笔记本上跑的小模型赢过一线大模型、21 个量化全崩的网格、单张成本差 40 倍、最大思考档烧掉 $3.30,以及 2026 年六家的“鸟骑车”各长什么样。末节是本机 125B 跑同一道题的结果。图片来自公开来源并逐张标注。
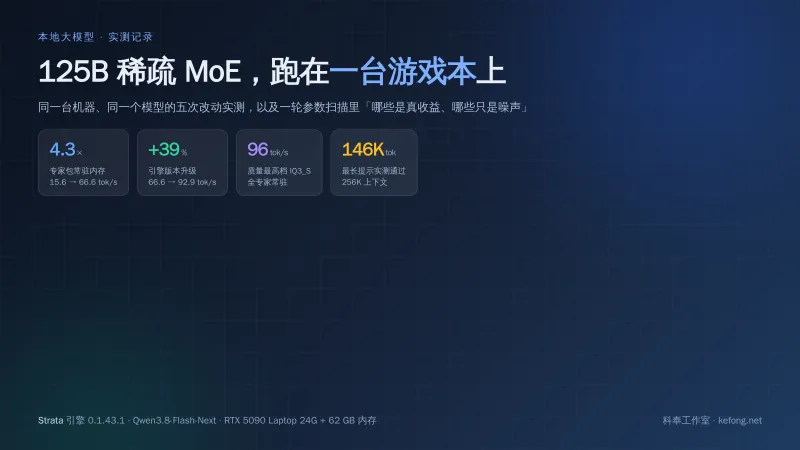
给本地大模型玩家的实测记录。在一台 RTX 5090 Laptop(24G 显存)+ 62 GB 内存的机器上跑 125B 稀疏 MoE,记录五次改动前后的速度变化:专家包整块常驻内存带来 4.3 倍、引擎升级带来 39%、去掉常驻预算参数带来 13%、提示分块放大带来 15% 的 prefill 提升;并附一轮 10 个参数的单变量扫描,指出其中 5 个只是测量噪声。含三档量化的质量-速度取舍、256K 长上下文(实测 14.6 万 token 提示)与可直接抄用的最终参数。
Qwen4 已被官方点名,但只是“在训练中”:没有模型卡、权重、API、定价与基准,官方四档命名(Max/Plus/Flash/27B)仅出自大会投屏,5–10T 参数说的是 Qwen4.5/Qwen5。本文把官方确认与传闻分开,梳理目前唯一可跑的架构预览版 Qwen3.8-Flash-Next(125B MoE、激活 6B、GDN+QSA 混合注意力、qwen-community-1.0 许可)、工程侧旁证(qwen4_exp 已进 transformers/vLLM/SGLang),并回答 35B 问题:官方没提,35B 属 Qwen3.5/3.6 与 UI-Agent 线,社区已有把 35B-A3B 移植进 Qwen4 架构的项目,附本地显存门槛对照表。