Strata 实测:125B MoE 跑在 62 GB 内存的游戏本上(附调参前后对比)
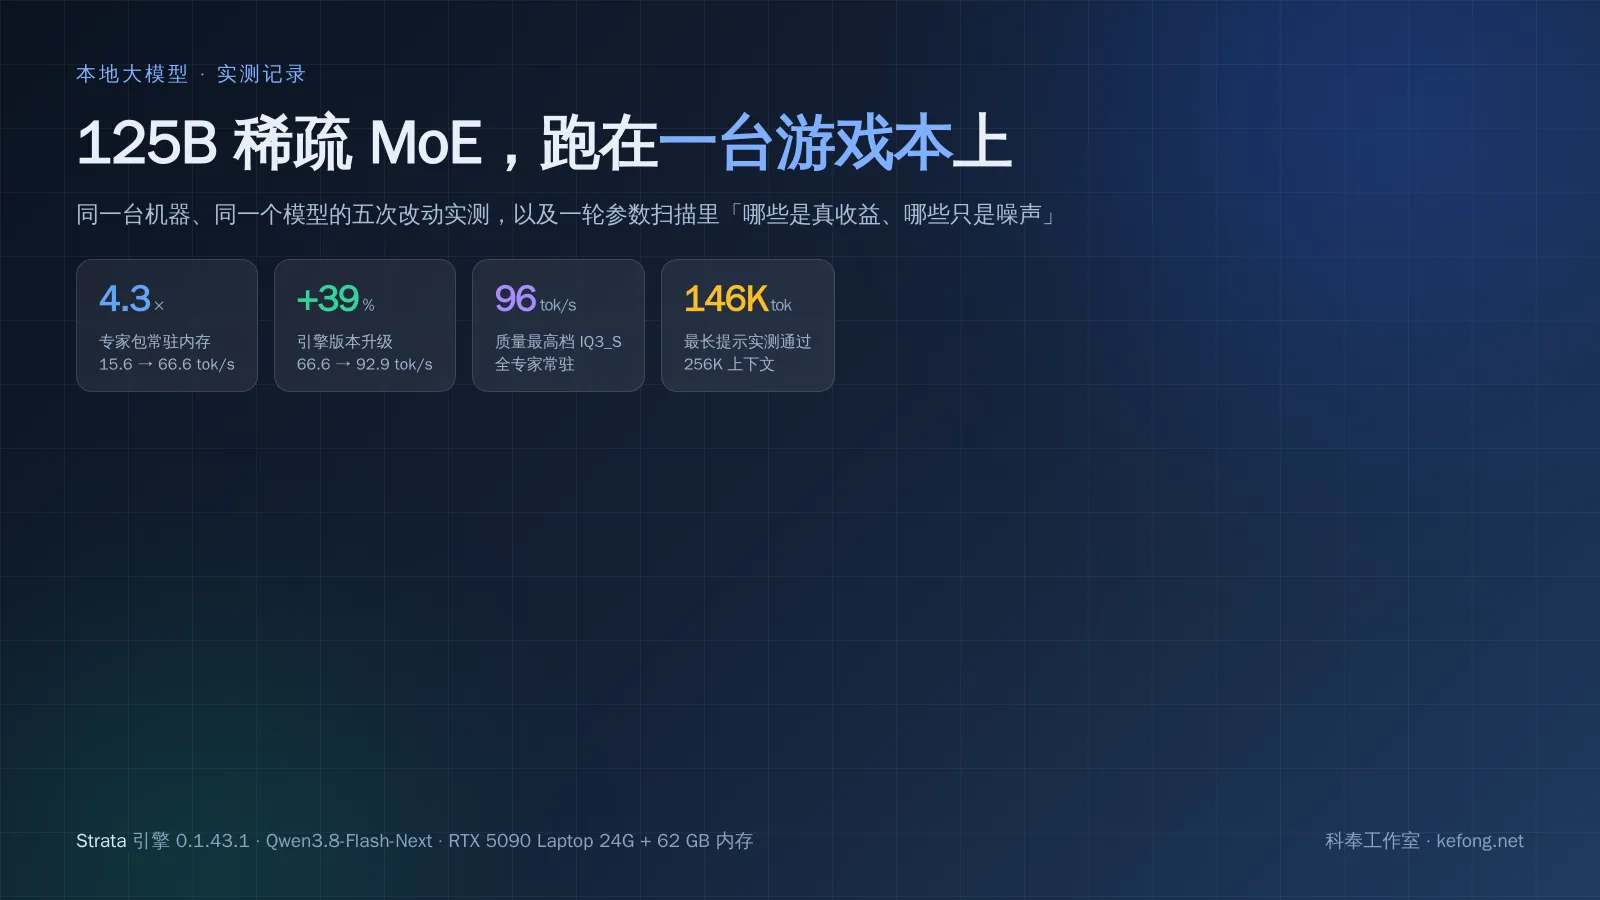
一台 24 GB 显存、62 GB 内存的游戏本,跑 125B 参数的稀疏 MoE 模型——这件事本身在一年前还属于"服务器专属"。但它跑起来只是第一步,跑得对不对是另一回事:这台机器上,同一份权重、同一台硬件,光是配置和引擎版本的差别,速度就能差出四五倍。
这篇文章记录的就是这个"从能跑到跑得对"的过程:五次改动的实测前后对比、一轮 10 余个引擎参数的单变量扫描(哪些是真收益、哪些只是测量噪声)、三档量化的质量-速度取舍,以及长上下文能开到多大。
一、先说结论
- 专家包必须整块常驻内存,这是这个引擎最重要的一件事。修复前后同一档位差 4.3 倍(15.6 → 66.6 tok/s)。
- 引擎版本很关键:0.1.40 → 0.1.43.1,解码再涨 39%(66.6 → 92.9 tok/s),专家缓存命中率 94% → 98%。
- 质量最高的档也能跑得快:官方质量第一的 IQ3_S,把专家包整块常驻内存后,128K 上下文下解码 96 tok/s,只比最轻档慢约 10%,质量却高出 4 个点。
- 调参要防噪声:两次同样配置的基线测速自己就差了 6.7%。不做交错对照,任何 ±3% 的"优化"都可能是假的——我这轮测下来的参数里,只有 4 个是真的有效。
- 长上下文能用:256K 配置实测喂进 145,864 token 的提示并通过关键信息召回(该长度已超过 131,072,128K 配置无法服务),prefill 稳定在 1500 tok/s 以上。
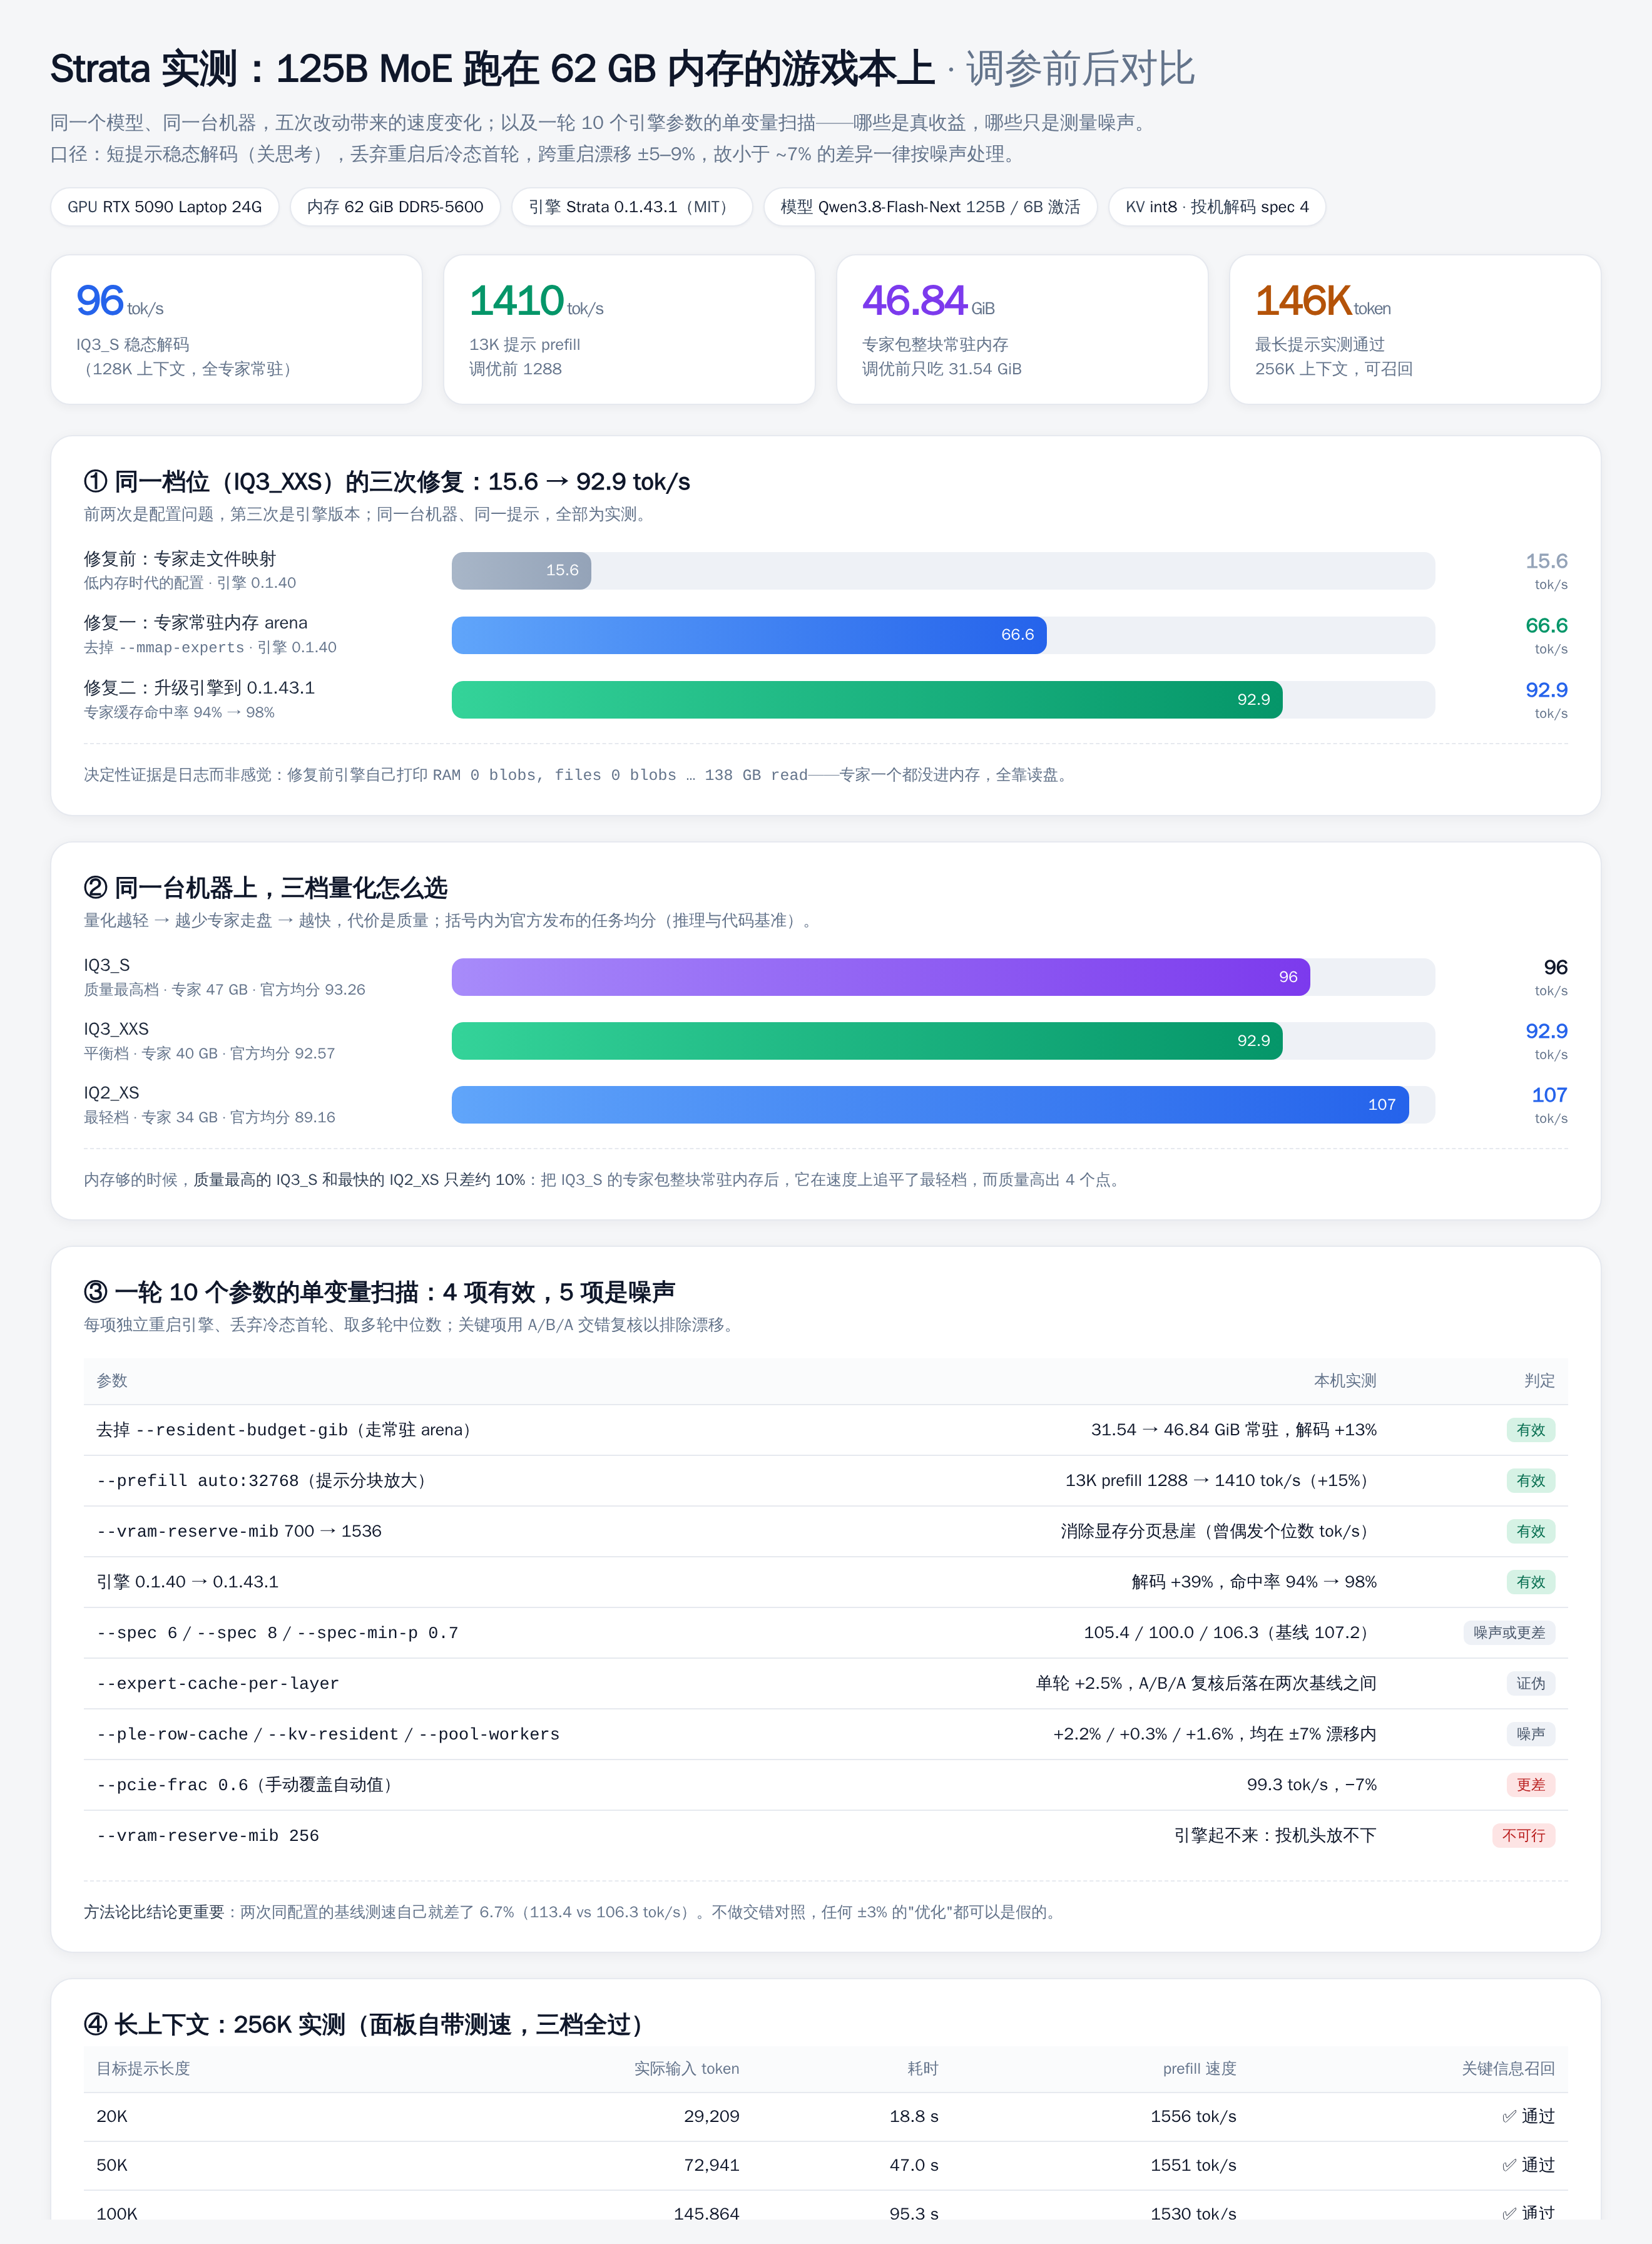
上图是本文全部实测数据的汇总:① 同一档位三次修复带来的速度阶梯;② 三档量化的质量-速度对照;③ 参数扫描里哪些有效、哪些是噪声;④ 256K 上下文的三档长提示实测。
二、Strata 是什么
Strata 是一个开源的本地大模型推理引擎(MIT、C++、构建在 llama.cpp/ggml 之上),由独立开发者维护,2026-09 下旬发布,迭代极快。它的定位很窄也很明确:只服务 Qwen3.8-Flash-Next 这一个模型,把这个模型的特殊结构吃透——所以它在这个模型上的速度远高于通用引擎,代价是不通用。
Qwen3.8-Flash-Next 是 Qwen4 架构的实验预览版(qwen4_exp):
| 项目 | 参数 |
|---|---|
| 总参数 / 每 token 激活 | 约 125B / 约 6B |
| MoE 结构 | 48 层 × 512 路由专家,每 token 激活 10 个 + 1 个共享专家 |
| 注意力 | Gated DeltaNet 线性注意力 + Qwen Sparse Attention(QSA)混合 |
| 其他 | HyperConnections、PLE n-gram 哈希嵌入表(51.2B 参数、约 28.8 GB) |
| 模态 | 原生多模态(视觉投影器 BF16 约 0.9 GB) |
引擎为这种结构做了几件专用的事,理解它们才能看懂后面的调参:
- 专家分层缓存:把每层专家打包成 blob,按热度分三层——显存里的专家缓存、内存里的常驻 arena、模型文件(SSD)。命中显存与内存时不碰盘,只有 miss 才读 SSD。
- PLE 表的按行流式读取:那张 28.8 GB 的 n-gram 表是"查表"而不是矩阵乘,每 token 只读一行,因此可以留在 SSD 上按需读,不必占内存。
- MTP 多 token 预测(投机解码):用一个小草稿头一次猜多个 token,再由主模型验证。
- KV 缓存 int8 / 流式:压缩长上下文的显存占用。
门槛要说清楚:官方说 12 GB 显存即可"入场",但那只是能跑。真正的门槛是内存——专家包 IQ2_XS 34 GB、IQ3_XXS 40 GB、IQ3_S 47 GB,加上代码与运行时,64 GB 内存是舒适线;SSD 也要留出对应空间(完整模型两片合计 68–84 GB,其中约 29 GB 的 PLE 表可以留在盘上)。显存越大越快,但显存不是决定性的那一项。
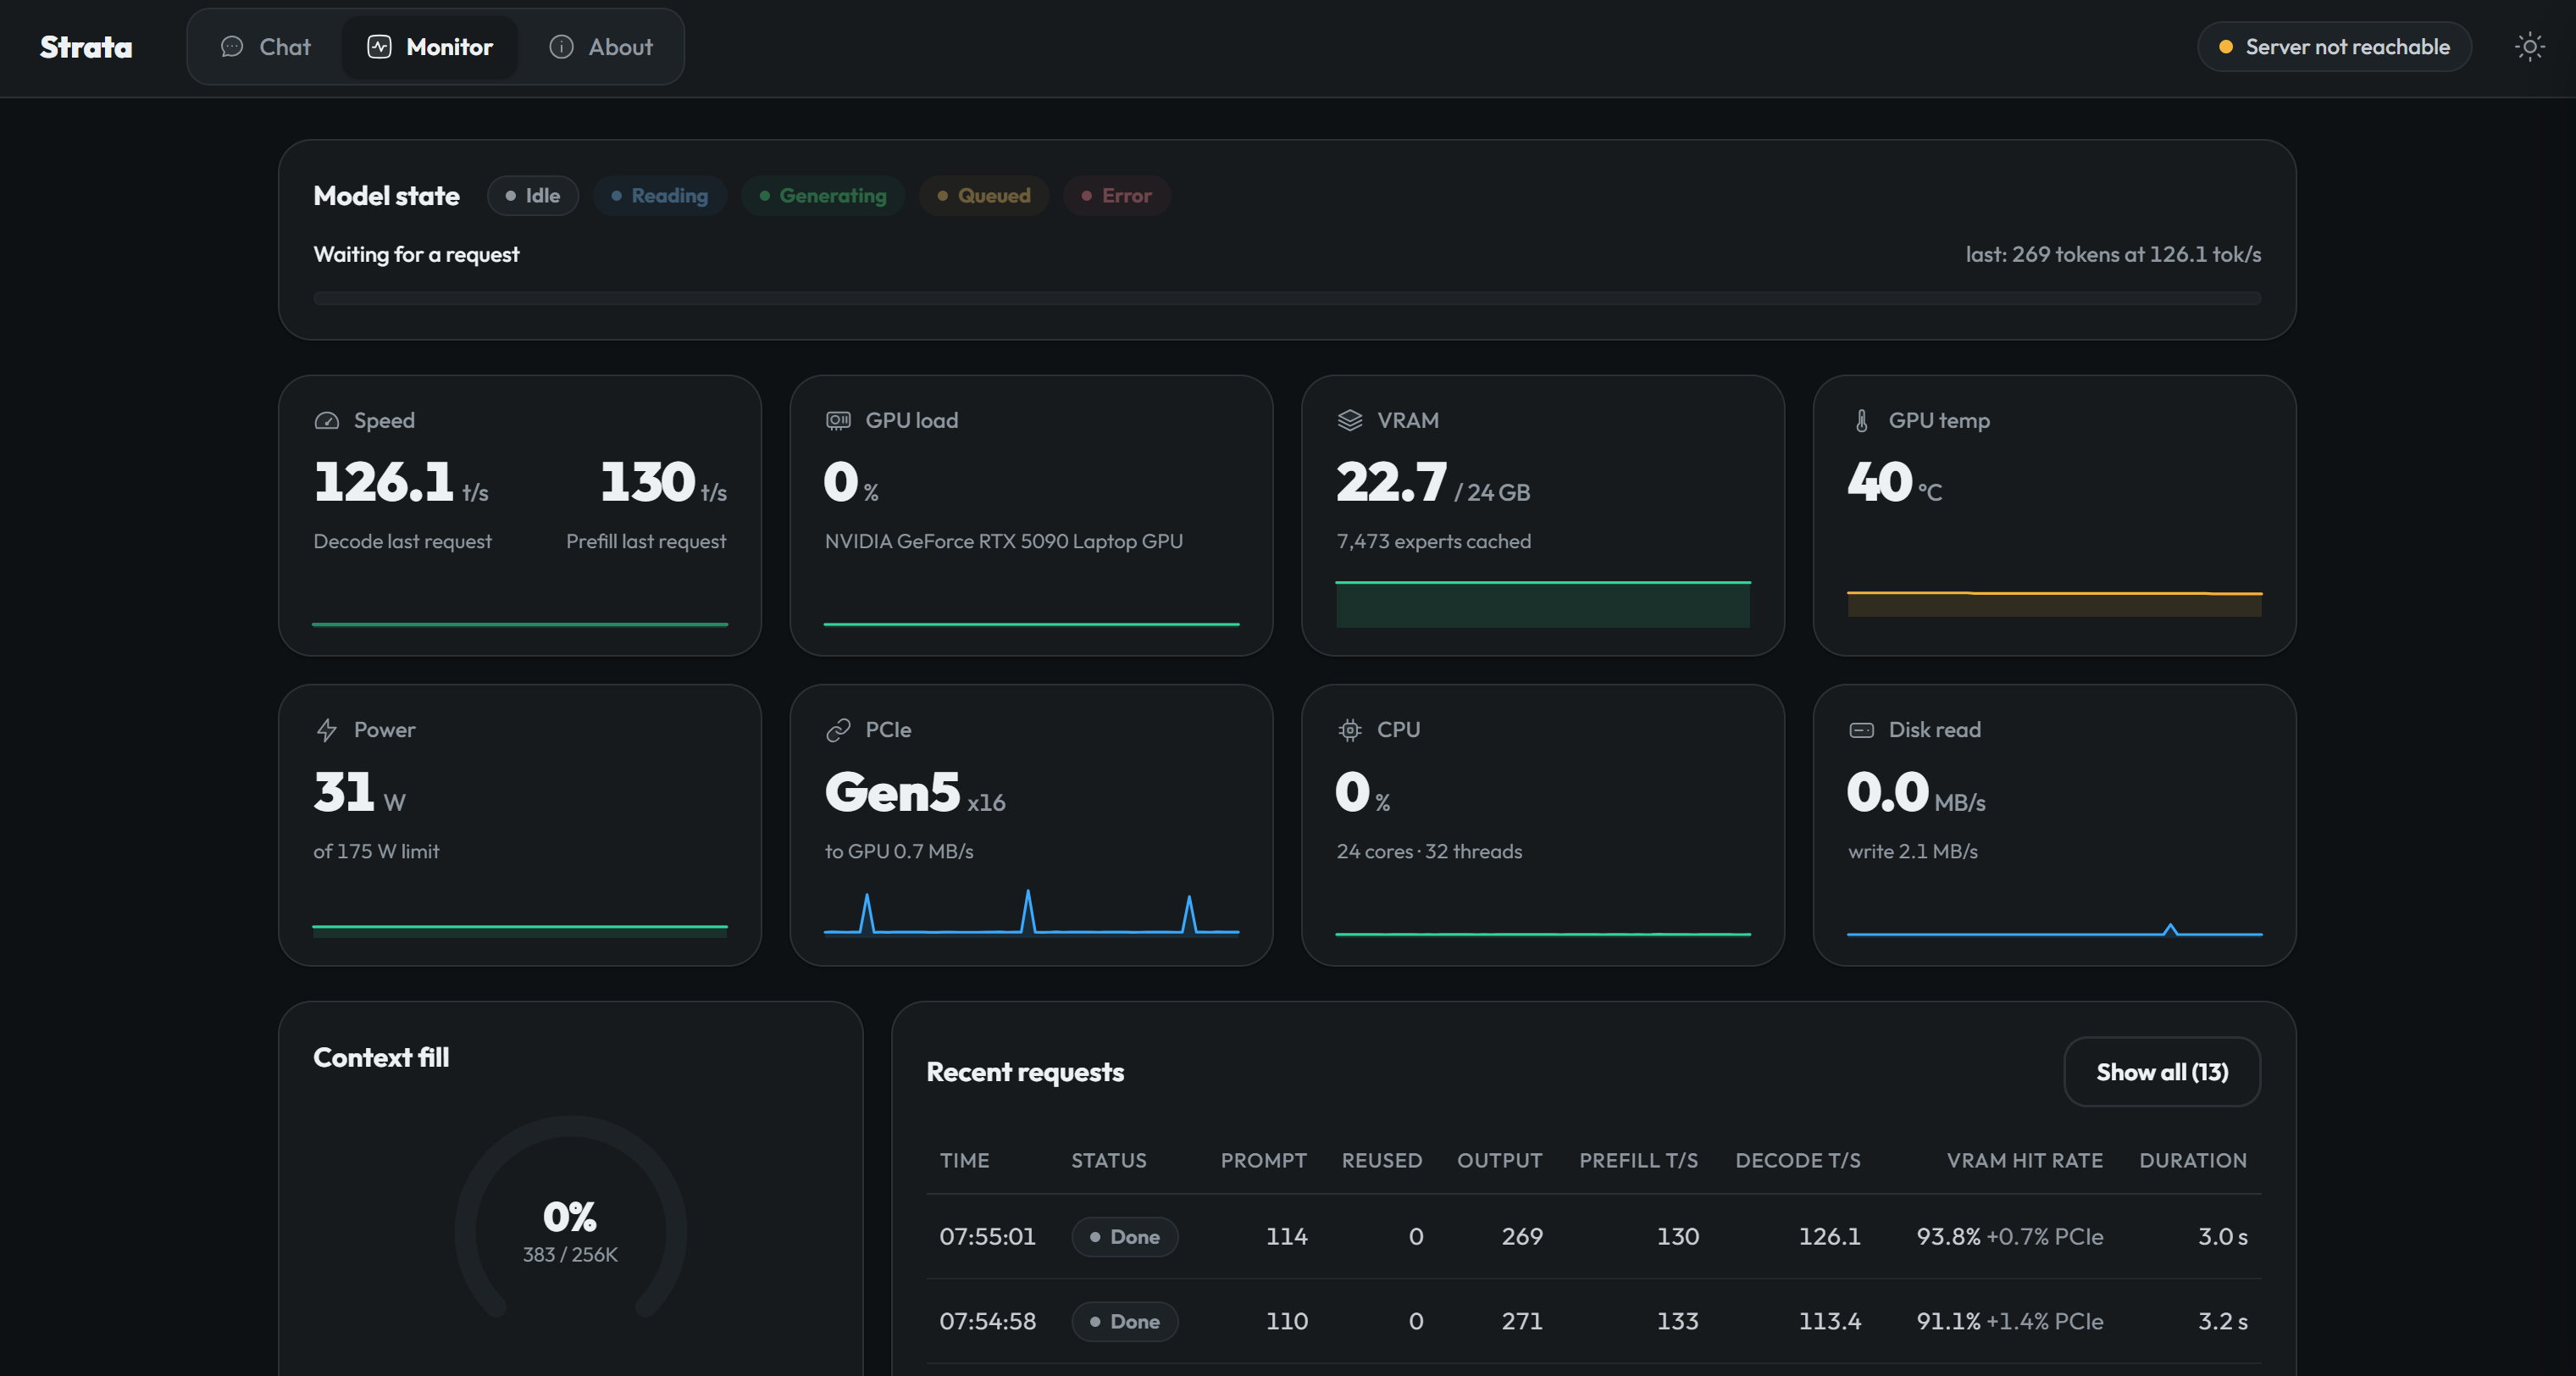
三、测试平台与测量口径
| 项目 | 配置 |
|---|---|
| GPU | RTX 5090 Laptop 24 GB(实测可用 24463 MiB) |
| 内存 | 62 GiB DDR5-5600(2×32 GB,主板上限 64 GB) |
| 存储 | NVMe,模型与专家包都在本地盘 |
| 引擎 | Strata 0.1.43.1(升级前 0.1.40) |
| 模型 | Qwen3.8-Flash-Next,GSQ-RCO 量化三档(IQ2_XS / IQ3_XXS / IQ3_S)+ BF16 视觉投影器 |
| 采样 | 关闭思考、temperature 0.3 |
口径(很重要,否则下面的数字没有可比性):
- 解码速度 =
completion_tokens ÷ 请求总耗时,丢弃引擎重启后的第一个请求(冷态离群值,实测能低到正常值的一半)。 - 跨重启漂移 ±5–9%:同一份配置重启两次基线,实测为 113.4 与 106.3 tok/s。所以小于 ~7% 的差异一律按噪声处理。
- prefill(读提示)用 13K token 的固定长提示测;同配置重复测量误差在 ±1% 以内,这一项反而很稳。
- 每项参数改动都独立重启引擎、丢弃首轮、取多轮中位数;关键项用 A/B/A 交错(基线→变体→基线)复核。
四、升级前后:初始状态加五次改动
| # | 改动 | 解码速度 | 变化 |
|---|---|---|---|
| 0 | 初始状态:专家走文件映射 + 旧引擎(0.1.40) | 15.6 tok/s | — |
| 1 | 去掉 --mmap-experts,改走常驻内存 arena |
66.6 tok/s | 4.3× |
| 2 | 引擎升级 0.1.40 → 0.1.43.1 | 92.9 tok/s | +39% |
| 3 | 质量最高档 IQ3_S 去掉 --resident-budget-gib |
88.8 → 90–97 tok/s | +13% |
| 4 | --prefill auto:32768(提示分块放大) |
13K prefill 1288 → 1410 tok/s | +15% |
| 5 | --vram-reserve-mib 700 → 1536 |
消除偶发个位数 tok/s 的显存分页悬崖 | 稳定性 |
改动 1:专家必须进内存。 决定性证据来自引擎自己的日志:
expert tiers: … RAM 0 blobs, files 0 blobs, 138 GB read专家一个都没进内存,全部靠读盘——那时机器只有 31 GB 内存,配置里写了 --mmap-experts(它的语义是"退出常驻专家 arena,改用文件映射")。内存升到 62 GB 后这个参数就从无奈之举变成了纯负担,删掉即得 4.3 倍。
改动 2:引擎版本。 0.1.43 一版里明确写了"专家缓存命中率提升"等改动,实测命中率从 94% 上到 98%、解码 +39%——同样的权重、同样的硬件。
改动 3:一个容易被误读的"天花板"。 IQ3_S 的配置里原有 --resident-budget-gib 46,但无论写 40 还是 46,引擎日志都只报:
resident RAM mode: 31.54 GiB of experts in RAM (page-locked)看起来像"内存天花板只有 31.5 GiB"。查过引擎二进制里的字符串才明白:这个参数会把引擎切到另一条代码路径(文件层的专家源),其预算会被 clamp_resident_budget 按"当前可用内存 − 4 GiB 余量 − 0.25 GiB 安全边界"夹住。可用内存之所以只有 35 GiB 左右,是因为那 28.8 GB 的 PLE 表的页缓存当时占了内存。
内存够的时候,根本不该设这个预算。 删掉它,引擎走默认的常驻 arena,整个 47 GB 专家包一次性锁进内存——用 /proc/<pid>/smaps 验证,进程里出现一块 46.84 GiB 的匿名映射,且其中 46.76 GiB 走的是透明大页(THP)。速度从 88.8 涨到 90–97 tok/s。
改动 4:提示分块放大。 这个参数只影响"读提示"(prefill),不影响生成速度。同一份配置交错测四轮:
--prefill |
四轮实测 | 中位 |
|---|---|---|
auto(默认) |
1230 / 1208 / 1255 / 1219 | 1228 tok/s |
auto:32768 |
1413 / 1421 / 1399 / 1404 | 1410 tok/s |
每轮自身离散度 <1%,两种设置交错出现——所以这 +15% 是真实的。有意思的是,引擎自己会为此打印一条警告(说 32768 的分块会把缓存槽借给提示路径、而那些专家不在内存里、可能慢 3 倍);但在 13K 这个尺度上分块装得下,警告没有兑现。提示长度到几十 K 时值得重测。
改动 5:别把显存留得太满。 日志里出现过这么一条,值得所有人注意:
WARNING: only 379 MiB of VRAM free at the start of this request (below 512 MiB):
when the card is this full the driver can page GPU memory to system RAM,
decode falls to a few tok/s and a window may never finish
把显存保留从 700 MiB 提到 1536 MiB 后,空闲显存回到约 1.2 GiB,警告消失,速度不变。这也是此前偶发个位数 tok/s 的根源——不是模型问题,是显存太满触发了驱动分页。
五、参数扫描:测了十多个,真正有效的只有 4 个
| 参数 | 本地实测 | 判定 |
|---|---|---|
走常驻 arena(去掉 --resident-budget-gib) |
31.54 → 46.84 GiB 常驻,+13% | ✅ 有效 |
--prefill auto:32768 |
prefill +15%(A/B/A/B 复核) | ✅ 有效 |
--vram-reserve-mib 700 → 1536 |
消除显存分页悬崖 | ✅ 有效 |
| 引擎 0.1.40 → 0.1.43.1 | +39% | ✅ 有效 |
--spec 6 |
105.4 tok/s(基线 107.2) | ⬜ 噪声 |
--spec 8 |
100.0 tok/s | ⬜ 噪声(略低) |
--spec-min-p 0.7 |
106.3 tok/s | ⬜ 噪声 |
--expert-cache-per-layer |
单轮 +2.5%,A/B/A 后落在两次基线之间 | ⬜ 证伪 |
--ple-row-cache 8M |
109.6 tok/s(+2.2%) | ⬜ 噪声 |
--kv-resident 20480 |
107.5 tok/s(+0.3%) | ⬜ 噪声 |
--pool-workers 20 |
108.9 tok/s(+1.6%) | ⬜ 噪声 |
--pcie-frac 0.6(手动覆盖自动值) |
99.3 tok/s,−7% | ⚠️ 更差 |
--vram-reserve-mib 256 |
引擎起不来(投机草稿头放不下) | ⚠️ 不可行 |
这张表里最有价值的一行是 --expert-cache-per-layer:单轮测量显示 +2.5%,看着像个免费收益;换成基线→变体→基线的交错顺序后,它正好夹在两次基线(113.4 / 106.3)之间。单次采样 + 没有对照 = 把噪声当收益报出去。
六、三档量化怎么选
官方模型卡给了逐档评测(GSQ-RCO 量化,四档都逐张量分配精度):
| 变体 | 位宽 | 体积 | AIME25 | GPQA-D | LiveCodeBench v6 | 任务均分 |
|---|---|---|---|---|---|---|
| BF16 基座 | 16.00 | 354 GB | 100.00 | 91.92 | 87.43 | 93.12 |
| Q2_0 | 2.40 | 66.4 GB | 96.67 | 89.39 | 81.14 | 89.07 |
| IQ2_XS | 2.50 | 68.0 GB | 96.67 | 87.37 | 83.43 | 89.16 |
| IQ3_XXS | 3.00 | 75.8 GB | 100.00 | 91.41 | 86.29 | 92.57 |
| IQ3_S | 3.50 | 83.6 GB | 100.00 | 92.93 | 86.86 | 93.26 |
IQ3_S 是官方推荐的档:AIME25 与基座持平、GPQA-D 还高 1 分、LiveCodeBench 只差 0.57,体积不到基座的四分之一。
落到本地部署的速度-质量关系:
| 档位 | 专家包 | 稳态解码(128K 上下文) | 官方质量均分 |
|---|---|---|---|
| IQ2_XS | 34 GB | 107 tok/s | 89.16 |
| IQ3_XXS | 40 GB | 92.9 tok/s | 92.57 |
| IQ3_S | 47 GB | 96 tok/s(90–97) | 93.26 |
结论:内存够就选质量最高的那一档。IQ3_S 常驻内存后在速度上追平了最轻档(差距约 10%,而质量高 4 个点)。选轻档的唯一理由是内存不够(比如 32 GB 机器)。
七、长上下文:256K 实测
把上下文从 128K 提到 256K——注意这会带来一点速度代价(IQ3_S 从 96 降到 83–86 tok/s,仍在前文 ±7% 的漂移带内,但方向上确实变慢了一点),换来的是能喂进更长的材料。用引擎/面板自带的长上下文测速跑三档(提示里埋一个编号,要求模型复述,检验是真的读进去了):
| 目标长度 | 实际输入 | 耗时 | prefill 速度 | 关键信息召回 |
|---|---|---|---|---|
| 20K | 29,209 token | 18.8 s | 1556 tok/s | ✅ |
| 50K | 72,941 token | 47.0 s | 1551 tok/s | ✅ |
| 100K | 145,864 token | 95.3 s | 1530 tok/s | ✅ |
第三档的输入 145,864 token 已超过 131,072,也就是说这个请求在 128K 配置下会直接超限报错——这是加长上下文的真实收益。
代价很小:引擎常驻内存从 52.6 GiB 涨到 53.1 GiB(256K 比 128K 多约 2.4 GiB),swap 用量 39 MiB,可用内存仍余约 7 GiB。
八、最终配置
以下是本地跑 IQ3_S 的完整参数(--pack/--native 等路径省略):
--expert-cache auto        # 显存专家槽按可用显存自动定
--prefill auto:32768       # 提示分块(本地实测 +15%)
--spec 4 --spec-min-p 0.5  # 投机解码:草稿 4 token
--kv int8                  # KV 缓存 int8
--kv-resident 20480        # KV 流式:每层保留 20480 单元在显存
--max-context 262144       # 256K 上下文
--vram-reserve-mib 1536    # 给驱动留出余量,避免显存分页
--pool-workers 15          # CPU 侧工作线程
--vision                   # 启用视觉(多模态)
# 不加 --mmap-experts、不加 --resident-budget-gib
验收方式(两处都要看):
# 1) 引擎自己报常驻模式
grep -a "resident RAM mode" strata.log          # 期望:46.xx GiB of experts in RAM
# 2) 进程里是否真有一块约 47 GB 的匿名映射(日志措辞在不同路径下相同,会骗人)
awk '/^Rss:/{if($2>524288)print "Rss GiB",$2/1048576} \
     /^AnonHugePages:/{print "AnonHuge GiB",$2/1048576}' /proc/$(pgrep -x strata)/smaps
# 期望:Rss 46.84 GiB / AnonHuge 46.76 GiB工程侧我把它纳入了自建的运维面板:按配置文件切换档位与上下文、开机自启、systemd 托管,面板上还有编程能力对比与长上下文测速两个测试入口。要注意的是面板的"内存模式"有三档(按需映射 / 显卡外常驻 / 全部常驻),只有"全部常驻"才对应本文的最优配置,选其它两档会把上面删掉的低内存参数加回来。
九、边界与适用性
- 12 GB 显存能跑,但别期待快:显存小意味着专家缓存命中率低,速度取决于你的内存与 SSD。这台 24 GB 卡 + 62 GB 内存的组合,解码大约 90–100 tok/s、13K 提示 prefill 约 1400 tok/s。
- 内存是硬门槛:专家包 34–47 GB,加上系统与运行时,32 GB 机器只能跑最轻档且会有一部分专家读盘;64 GB 是舒适线。
- 单请求为主:这类引擎默认面向单路推理;多路并发要自己压测。
- 质量边界:IQ3_S 在官方评测上与 BF16 基座基本持平,但更低的档(IQ2_XS/Q2_0)在代码与推理基准上会掉 3–4 分,做代码任务时值得优先选高质量档。
- 想要"无审查"版本也可以:社区有该模型的 abliterated 版本(
orcarouter/Qwen3.8-Flash-Next-Uncensored),引擎文档里有专门的手动接入说明(要把普通量化里被压缩的超连接/注意力投影展开回 BF16、PLE 表按 mmap 读、MTP 草稿头要另配)。代价是体积更大(IQ3_XXS 两片约 85 GB)与常驻内存需求更高(约 49.8 GiB),属于"能跑但要手工"的范畴。 - 关于"比 llama.cpp 快多少":引擎文档自己都不承诺在同条件下胜过 llama.cpp,社区的同条件复测大致在 2 倍量级,而官方给出的对比数字是另一套口径。不同配置、不同提示、不同输出长度之间比速度没有意义,要报就分开报 prefill 与 decode。
十、给同样想折腾的人的三条经验
- 先看日志,再看速度表。这个引擎会在日志里直接告诉你专家是"在内存里"还是"在读盘"(
RAM 0 blobs … 138 GB read)、显存是否太满、投机草稿头是否放不下。90% 的"慢"都能在日志里找到答案。 - 别把历史配置带到新硬件上。
--mmap-experts这类参数是为低内存机器准备的,内存翻倍后它变成纯粹的负担——升级硬件后要重新审视每一个"当年为了省内存"的参数。 - 测量纪律比调参技巧更重要。先测出你这台机器的漂移幅度(同一配置重启两次),再决定多大的差异值得相信。我这一轮里,一个"看着有 +2.5% 收益"的参数在交错对照下直接归零;十多个参数里真正站得住的只有 4 个。
参考
- 引擎仓库:
github.com/Niko1221/Strata(MIT;文档docs/下有低内存模式、长上下文与第三方变体的说明) - 量化与评测:
huggingface.co/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF(含四档量化的逐项评测与显存建议) - 量化方法论文:GSQ(Gumbel-Softmax 量化,arXiv:2604.18556)、RCO(黎曼约束下的比特预算分配,arXiv:2605.00649)
- 通用引擎侧的架构支持:llama.cpp 的
qwen4exp支持与 MTP 推理路径(PR #27742 / #28243)
本文只做技术记录,不含任何购买入口。